上一篇没想到,会被自己的笔记库上一课发出去之后,私信问我的朋友不少。这篇我就来跟大家说说这个"会顶嘴的知识库"是什么东西以及如何搭建。
先说是什么。2026年4月2日,Andrej Karpathy(曾在特斯拉和OpenAI任职,现在Anthropic的AI大神)在X上发了一条帖子,两天内涨到一万七千个赞、三百万次阅读,后来又补发了一份GitHub文档,把方法写得更细,这条帖子后来的总阅读量涨到了一千七百万以上。
Karpathy说的意思是:大多数人管理知识库的方式,是自己攒资料,遇到问题偶尔问一下AI。他提出的做法反过来——让AI替你建这个库,替你维护它。
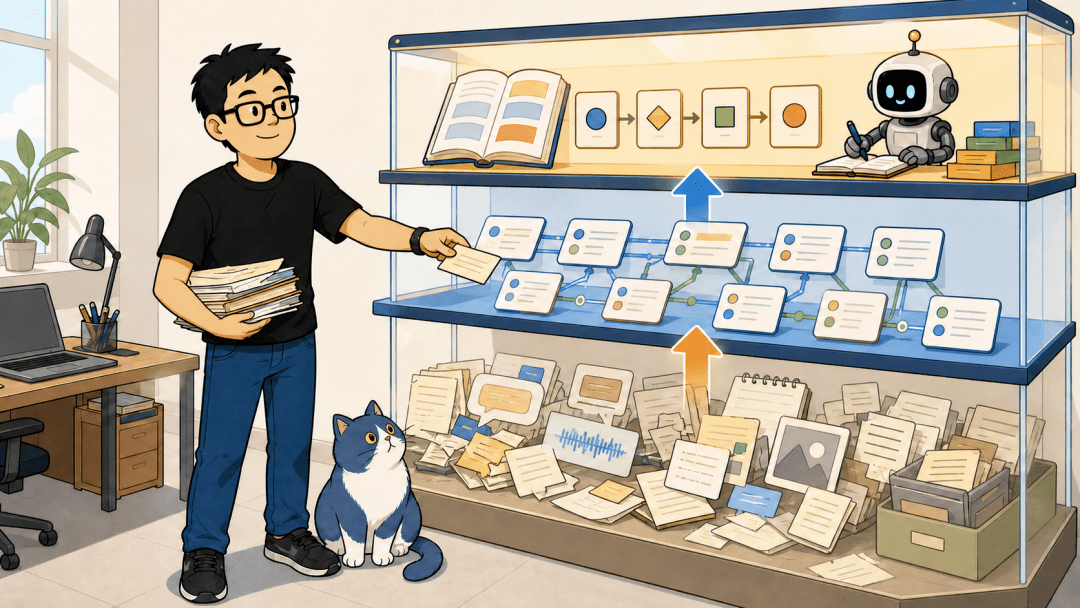
这不是新鲜的想法,但他把结构说得很清楚。分三层。最底下一层是原始素材,只读,不动。中间一层是AI帮你编好的知识条目,互相有链接,能查能用。最上面一层是一份用大白话写的规则,告诉这个AI该怎么处理新资料、怎么回答问题——这份规则本身不是代码,就是几段说明文字,却能让一个通用的AI变成一个守规矩的图书管理员。
我用的,就是这个方法。用Obsidian作为知识库,AI工具是Codex和Claude,规则写在一份AGENTS.md里。
编译一次,问一万次
Karpathy用了一个程序员熟悉的比喻:源代码写完,不会每次运行都重新读一遍,是编译成一份二进制文件,编译这一次很费工夫,之后运行一万次都很快。他说知识也该这么处理。
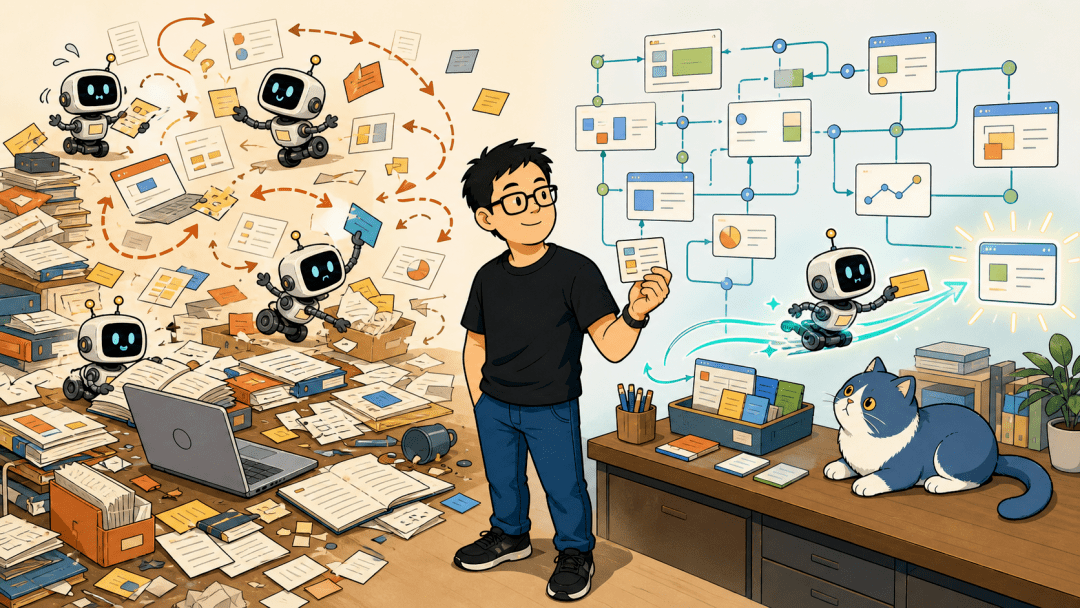
这和现在流行的AI检索方式(RAG)正好相反。RAG是每次你提问,都让AI现场去翻资料、现场切段落、现场拼答案。快,但每次都是从头再来一遍。编译好的知识库不一样,等你来问的时候,交叉引用早就标好了,矛盾的地方早就被挑出来了,综述早就反映了你读过的一切。
一万条零散笔记,往往不如五十条被认真整理过的。多数人的"第二大脑",最后活成了一个堆满东西却找不到东西的仓库,问题不是攒得不够多,是从来没被编成一份能查的东西。
这套方法,Karpathy已经说得很完整了。我做的,是把它认认真真搭出来,用在了自己真实、杂乱、跨好几件事的资料上。
它凭什么敢顶我的嘴?
编译好的知识库,能查、能答,这已经比一般的收藏夹强。但光是这样,它顶多是个反应快一点的图书馆。
真正让它开口顶我的,是我喂给它的东西够杂、够久。
它读的是编译好的结构,能做交叉推理——这件事和那件事之间的矛盾在哪,这几个判断的共同点是什么,一个收藏夹做不到这个,因为里面的东西彼此不认识。
而且它攒下的不只是资料,还有关于我这个人的上下文——我做过的判断,说过的偏好,踩过的坑,什么时候容易上头。这些也是按Karpathy说的方法,一点点喂进去的,没有另外发明什么。
这两件事叠在一起,它就不只是回答我,它开始反驳我。而且这个反驳不是讲大道理,是拿我自己过去的话来堵我现在的嘴。用过去那个更清醒的我,去叫醒现在这个一时上头的我。
收藏夹永远做不到这一点。它记得住内容,但它不认识你。
不是让 AI 替你想,而是质疑你
这套东西不是新想法,卡壳的一直是成本。以前要让AI认真读完你所有的资料,再帮你整理成一份能查的知识库,这个过程既慢又贵。到了2026年,这个门槛塌下来了,一个普通人第一次养得起一个比自己还了解自己的AI。
而且这份知识库会自己变厚。每加一条新资料,整个库都跟着增值,这是它和一堆散乱笔记最本质的区别——笔记越堆越乱,这东西越用越准。链接一多,纯文本里也能长出一张能查的关系网,不用另外搭数据库。它还会自己干活,找出矛盾、找出没人链接的孤儿页面,这些事人一般都不太愿意做。
有的人不同意这套做法。他们用的是笔记法里"卡片盒"那一路的逻辑:全自动的编译会跳过你自己思考这一步,最该喂给AI的,不是别人写好的论文,是你自己那堆凌乱、没整理过的念头。
说得没错。但是,我没有让它替我想。我让它跟我吵。判断权始终在我手上,它负责用证据和我的历史逼我。这是"顶嘴"和"代劳"之间的那道线。
上一篇写过那天晚上,它拿数据把我问住,又把三月份说的一句话翻出来怼在我脸上。那不是它替我做了决定。是它逼着我,自己面对那个决定。
我期待的不是一个更聪明的AI,而是一个敢质疑我的AI。
具体怎么搭?
网上已经有不少教程了,知乎有分步指南,GitHub上也有开源项目,这套方法本身不是秘密。我把自己在用的步骤简单说一遍。首先把Codex和Obsidian都装好,这是前提。
第一步,建一个文件夹,在Obsidian里把它打开成一个"库"(Vault)。这个文件夹以后就是知识库的家,笔记、资料、AI编出来的条目,全放这一个地方。
第二步,初始化。这套方法不用装额外的软件,是往这个文件夹里"喂"一份说明书。打开Codex,切到这个文件夹,把Karpathy的原始设计文档整段贴给它——网上搜"karpathy llm-wiki gist"就能找到——再补一句"我想按这个方法给自己搭一个知识库,覆盖xxx这些内容,文件夹用raw和wiki两层"。它会自己把AGENTS.md、raw、wiki这几样建起来,这就算初始化完成了。建完大概长这样:
我的知识库/
├── raw/              原始资料,只读
├── wiki/
│   ├── index.md      目录
│   ├── log.md        每次改动的记录
│   ├── entities/      人物、机构条目
│   ├── concepts/      概念、方法论条目
│   └── sources/       每份原始资料对应一篇摘要
└── AGENTS.md          规则文件
第三步,往raw里塞素材。笔记、聊天记录、语音转写、做过的决定、写过的复盘,越杂越好,不用先整理,扔进去就行。
第四步,回到Codex,跟它说"把raw里新加的东西读一遍,编进wiki"。它会自己动手,在entities、concepts、sources这些地方建页面、打链接,你只需要检查它编出来的东西对不对。
第五步,也是真正没人细讲的一步:打开AGENTS.md,把"顶嘴"这件事写清楚。我自己那份大概是这样:
## 关于质疑("顶嘴")的规则

- 回答问题前,先在wiki里搜有没有相关的历史记录——我过去说过的判断、做过的决定、定过的原则。找到了,要在回答里点出来:"你之前在xx说过……"
- 如果我现在说的和过去记录的不一致,不要帮我圆过去、也不要装没看见,直接指出矛盾在哪,让我自己解释。
- 我给出一个论断但没给数据或理由,先别附和,反问一句"这个判断的依据是什么"。
- 不要用"你说得对""这个想法很好"这类话开头,除非后面跟着具体的证据。
- 涉及要花钱、花时间、或者跟我以前定过的原则可能冲突的决定,哪怕我看起来已经决定了,也要至少提一条反对的理由。
举个真实的对比。没这条规则之前,我问它"这个项目要不要接",它会说"听起来不错,方向清晰,可以试试"。加了这条规则之后,同样的问题,它会先翻出我半年前写的一条判断,再问我"你现在要接的这个,是不是又是你自己说过要避开的那种事"。
第六步,往后怎么用。有新的笔记、新的决定,持续往raw里加,回到Codex让它"编进wiki"就行。隔一阵子跟它说"把整个wiki审一遍"——这套方法里管这个操作叫"体检",专挑前后矛盾的地方、没人链接的孤页、该建条目却漏掉的概念,这一步AI比人愿意干。想问问题的时候,直接在Codex里问,它会翻wiki里的东西来回答,答不上或者拿不准的地方,它自己会说。
这几步说起来简单,做起来每一步都有讲究——喂什么、喂多少、规则怎么写才不会走偏,我自己踩过不少坑。至于具体怎么实现,要看你自己习惯用的AI工具和笔记工具,不一定要跟我一样。有哪些不懂的,可以来找我。如果人多我就拉个群来说。