Après la publication de mon précédent article, Je ne pensais pas que ma propre base de notes me donnerait une leçon, plusieurs amis m’ont écrit en privé pour me poser des questions. Je vais donc expliquer ici ce qu’est cette « base de connaissances qui vous tient tête » et comment la construire.
Commençons par ce que c’est. Le 2 avril 2026, Andrej Karpathy (une grande figure de l’IA, ancien de Tesla et d’OpenAI, aujourd’hui chez Anthropic) a publié un message sur X. En deux jours, il avait obtenu 17 000 mentions « J’aime » et trois millions de vues. Il a ensuite publié un document GitHub plus détaillé pour expliquer la méthode, et le nombre total de vues du message a dépassé les 17 millions.
L’idée de Karpathy est la suivante : la plupart des gens gèrent leur base de connaissances en rassemblant eux-mêmes des documents et en posant de temps en temps une question à l’IA. Il propose l’inverse : laisser l’IA construire et entretenir cette base à votre place.
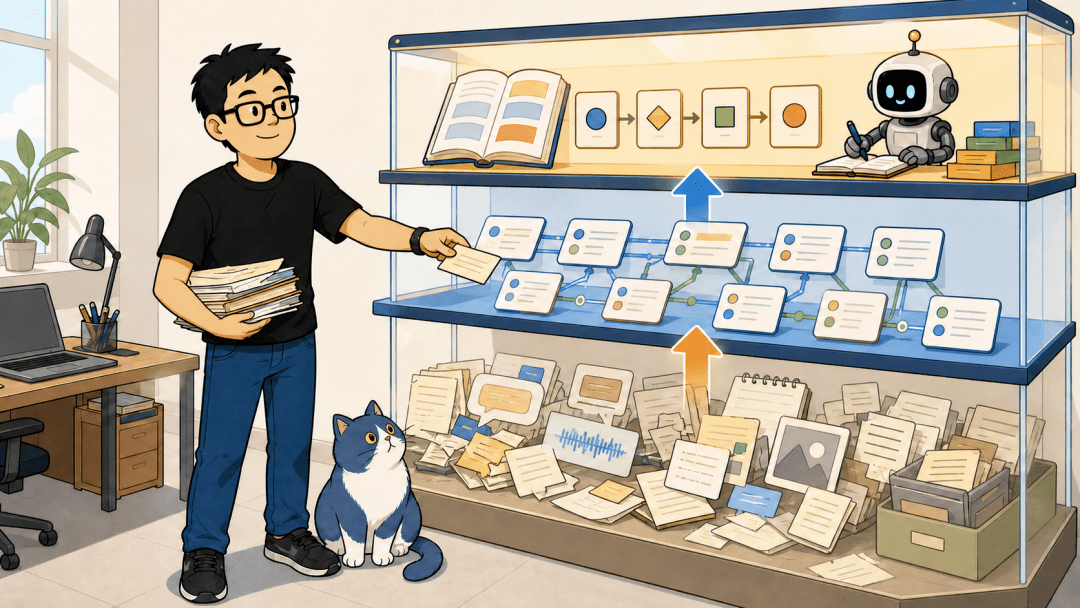
L’idée n’est pas nouvelle, mais il en a clairement décrit la structure en trois niveaux. Tout en bas, les sources brutes, en lecture seule, qu’on ne modifie pas. Au milieu, des fiches de connaissances organisées par l’IA, reliées entre elles, consultables et utilisables. Tout en haut, un ensemble de règles rédigées en langage courant qui expliquent à l’IA comment traiter les nouveaux documents et répondre aux questions. Ces règles ne sont pas du code, seulement quelques paragraphes d’instructions, mais elles transforment une IA généraliste en bibliothécaire discipliné.
C’est la méthode que j’utilise. Ma base de connaissances est dans Obsidian ; mes outils d’IA sont Codex et Claude ; et les règles sont consignées dans un fichier AGENTS.md.
Compiler une fois, interroger dix mille fois
Karpathy a utilisé une comparaison familière aux programmeurs : une fois le code source écrit, on ne le relit pas depuis le début à chaque exécution. On le compile en un fichier binaire. La compilation demande beaucoup de travail une fois ; ensuite, on peut l’exécuter dix mille fois rapidement. Selon lui, il faudrait traiter les connaissances de la même manière.
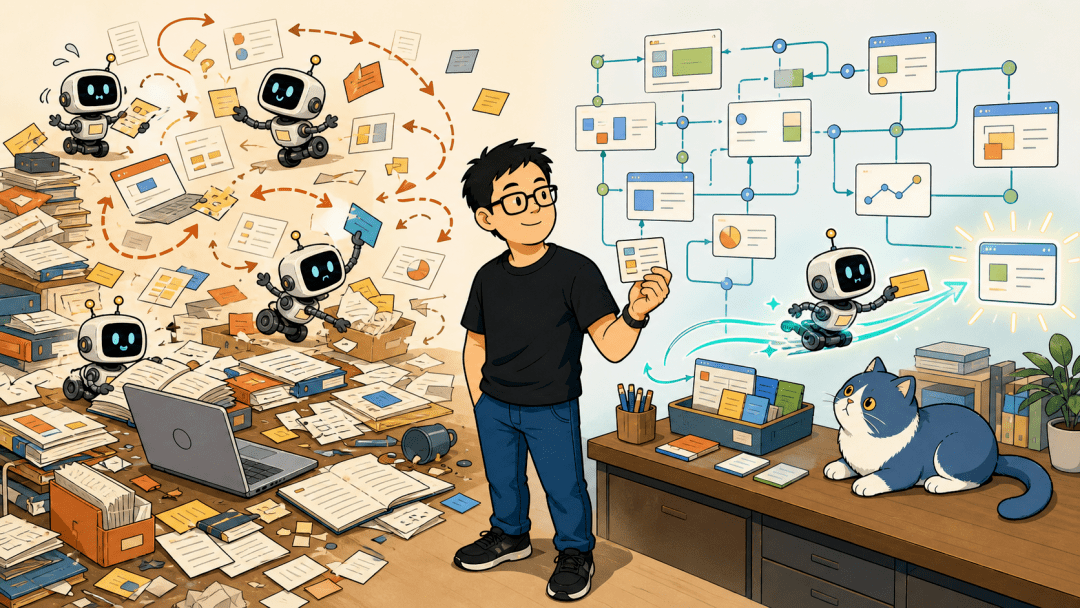
C’est exactement l’inverse de la méthode de recherche par IA actuellement très répandue, le RAG. Avec le RAG, à chaque question, l’IA retourne chercher des documents, découpe des passages et assemble une réponse sur le moment. C’est rapide, mais tout recommence à zéro chaque fois. Une base compilée fonctionne autrement : quand vous posez votre question, les renvois ont déjà été établis, les contradictions ont déjà été repérées et les synthèses reflètent déjà tout ce que vous avez lu.
Souvent, cinquante notes bien organisées valent mieux que dix mille notes éparpillées. Le « second cerveau » de la plupart des gens finit en entrepôt plein de choses où l’on ne retrouve rien. Le problème n’est pas d’avoir accumulé trop peu de documents, mais de ne jamais les avoir compilés en un ensemble consultable.
Karpathy avait déjà expliqué la méthode dans ses grandes lignes. Moi, je l’ai construite sérieusement et appliquée à mes propres documents, réels, désordonnés et liés à plusieurs projets différents.
Qu’est-ce qui lui donne le culot de me contredire ?
Une base compilée peut rechercher des informations et répondre aux questions. C’est déjà mieux qu’un simple dossier de favoris. Mais si elle s’arrête là, ce n’est qu’une bibliothèque un peu plus rapide.
Ce qui la fait vraiment prendre la parole et me contredire, c’est la variété et l’ancienneté des éléments que je lui ai confiés.
Elle lit une structure compilée et peut raisonner d’un élément à l’autre : où se trouve la contradiction entre deux événements, quel point commun partagent plusieurs jugements. Un dossier de favoris en est incapable, car les éléments qu’il contient ne se connaissent pas entre eux.
Elle a aussi accumulé autre chose que des documents : du contexte à mon sujet — les jugements que j’ai portés, les préférences que j’ai exprimées, les erreurs que j’ai faites et les moments où j’ai tendance à m’emballer. Ces éléments ont eux aussi été ajoutés petit à petit selon la méthode de Karpathy ; je n’ai pas inventé de processus séparé.
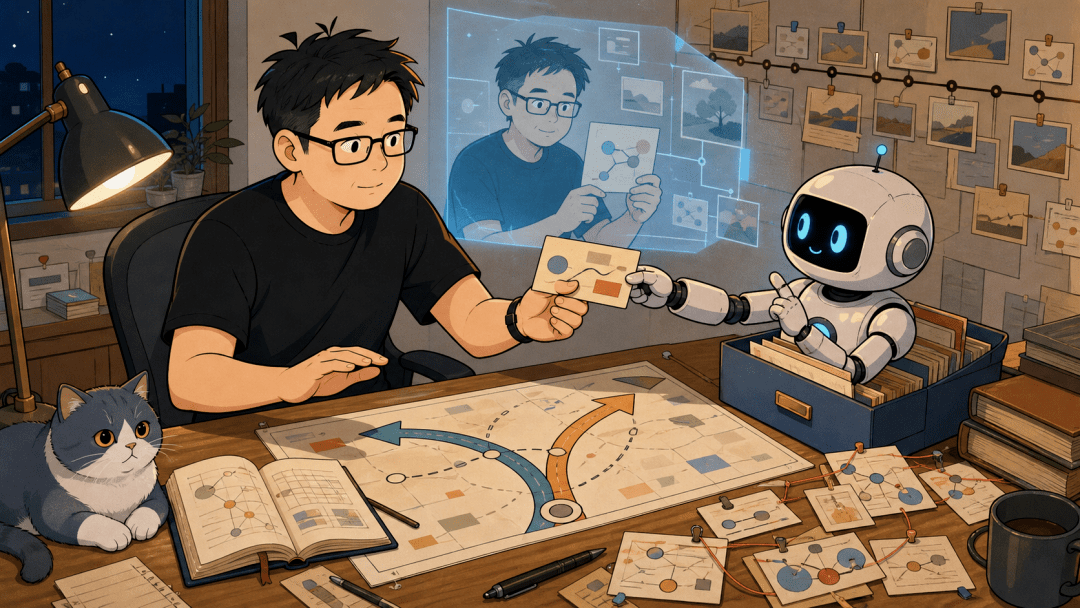
Quand ces deux dimensions se rejoignent, elle ne se contente plus de me répondre : elle commence à discuter avec moi. Et ses objections ne sont pas de grands principes abstraits ; elle me ressort mes propres paroles d’autrefois pour m’empêcher de dire n’importe quoi aujourd’hui. Elle se sert du moi plus lucide du passé pour réveiller le moi du présent, emporté par l’enthousiasme du moment.
Un dossier de favoris n’en sera jamais capable. Il retient le contenu, mais il ne vous connaît pas.
Il ne s’agit pas de penser à votre place, mais de vous remettre en question
L’idée n’est pas neuve. Le blocage a toujours été le coût. Jusqu’ici, demander à l’IA de lire attentivement tous vos documents, puis de les organiser en une base consultable, prenait du temps et coûtait cher. En 2026, le seuil s’est effondré : pour la première fois, une personne ordinaire peut s’offrir une IA qui la connaît mieux qu’elle-même.
Et cette base s’enrichit toute seule. Chaque nouvel élément augmente la valeur de l’ensemble. C’est ce qui la distingue fondamentalement d’une pile de notes éparses : les notes deviennent de plus en plus désordonnées ; ce système devient de plus en plus précis à mesure qu’on s’en sert. À force de liens, un réseau de relations consultable peut émerger du simple texte, sans qu’il soit nécessaire de créer une base de données à part. Le système travaille aussi de lui-même : il repère les contradictions et les pages orphelines qu’aucun lien ne relie — un travail dont les gens se passent volontiers.
Certaines personnes ne sont pas d’accord avec cette approche. Elles suivent la logique du Zettelkasten : une compilation entièrement automatique sauterait l’étape où l’on pense soi-même ; ce qu’il faut surtout donner à l’IA, ce ne sont pas les articles écrits par d’autres, mais nos propres idées, encore en désordre et non organisées.
C’est juste. Mais je ne lui demande pas de penser à ma place. Je lui demande de se disputer avec moi. La décision m’appartient toujours ; son rôle est de me confronter à des preuves et à mon propre passé. Voilà la frontière entre « me tenir tête » et « faire le travail à ma place ».
Dans mon précédent article, je racontais cette soirée où elle m’avait coincé avec des chiffres, puis m’avait ressorti une phrase que j’avais prononcée en mars pour me la mettre sous le nez. Elle n’avait pas pris la décision à ma place. Elle m’avait obligé à l’assumer moi-même.
Ce que je veux, ce n’est pas une IA plus intelligente, mais une IA qui ose me remettre en question.
Comment la construire concrètement ?
Les tutoriels ne manquent pas sur Internet. Zhihu propose des guides étape par étape et GitHub héberge des projets open source ; la méthode n’a rien de secret. Je vais résumer les étapes que j’utilise. Pour commencer, installez Codex et Obsidian : c’est indispensable.
Première étape : créez un dossier et ouvrez-le dans Obsidian comme un « coffre » (vault). Ce dossier deviendra le foyer de votre base de connaissances. Notes, sources et fiches compilées par l’IA seront toutes au même endroit.
Deuxième étape : l’initialisation. Cette méthode ne demande aucun logiciel supplémentaire ; il suffit de « nourrir » le dossier avec un jeu d’instructions. Ouvrez Codex, placez-vous dans ce dossier et collez-lui le document de conception original de Karpathy en entier — cherchez « karpathy llm-wiki gist » sur Internet — puis ajoutez : « Je veux construire ma base de connaissances selon cette méthode, sur les sujets xxx, avec deux niveaux de dossiers appelés raw et wiki. » Il créera lui-même AGENTS.md, raw et wiki. L’initialisation est terminée. La structure ressemblera à peu près à ceci :
Ma base de connaissances/
├── raw/              sources brutes, en lecture seule
├── wiki/
│   ├── index.md      index
│   ├── log.md        historique des modifications
│   ├── entities/     fiches de personnes et d’organisations
│   ├── concepts/     concepts et méthodes
│   └── sources/      un résumé pour chaque source
└── AGENTS.md         fichier de règles
Troisième étape : ajoutez des éléments dans raw. Notes, conversations, transcriptions audio, décisions prises, bilans écrits : plus le contenu est varié, mieux c’est. Ne commencez pas par le classer ; déposez-le tel quel.
Quatrième étape : retournez dans Codex et dites-lui : « Lis les nouveaux éléments de raw et compile-les dans le wiki. » Il créera lui-même des pages et des liens dans entities, concepts et sources. Vous n’aurez qu’à vérifier si le résultat est correct.
Cinquième étape, et c’est celle que personne n’explique vraiment en détail : ouvrez AGENTS.md et écrivez clairement les règles qui l’autorisent à « vous tenir tête ». Les miennes ressemblent à ceci :
## Règles pour me remettre en question (« me tenir tête »)

- Avant de répondre, cherche dans le wiki les traces pertinentes de mon passé : jugements formulés, décisions prises et principes établis. Si tu en trouves, signale-le dans ta réponse : « Tu as dit plus tôt que… »
- Si ce que je dis maintenant contredit une note antérieure, ne cherche pas à justifier le changement et ne fais pas semblant de ne rien voir. Indique directement la contradiction et laisse-moi l’expliquer.
- Si j’avance une affirmation sans données ni raisons, ne sois pas d’accord tout de suite. Demande-moi : « Sur quoi repose ce jugement ? »
- Ne commence pas par « Tu as raison » ou « C’est une excellente idée », sauf si tu apportes ensuite des preuves concrètes.
- Pour toute décision qui coûte de l’argent ou du temps, ou qui risque de contredire un principe que j’ai établi auparavant, présente au moins un argument contraire, même si j’ai l’air d’avoir déjà décidé.
Voici un exemple réel. Avant cette règle, quand je demandais « Dois-je accepter ce projet ? », elle répondait : « Ça a l’air intéressant. La direction est claire, tu peux essayer. » Une fois la règle ajoutée, à la même question, elle a d’abord retrouvé un jugement que j’avais écrit six mois plus tôt, puis m’a demandé : « Le projet que tu veux accepter maintenant ne fait-il pas partie de ceux que tu avais dit vouloir éviter ? »
Sixième étape : la suite. Ajoutez régulièrement les nouvelles notes et décisions à raw, puis retournez dans Codex et demandez-lui de les « compiler dans le wiki ». De temps en temps, demandez-lui de « passer le wiki entier en revue ». Dans cette méthode, on appelle cela un « bilan de santé » : l’IA cherche les contradictions, les pages orphelines sans aucun lien et les concepts qui devraient avoir leur propre fiche mais n’en ont pas. Elle est plus disposée que les humains à faire ce travail. Quand vous avez une question, posez-la directement à Codex. Il cherchera la réponse dans le wiki ; s’il ne sait pas ou s’il hésite, il vous le dira.
Ces étapes ont l’air simples, mais chacune comporte ses subtilités : quoi fournir, en quelle quantité et comment écrire les règles pour éviter que le système ne dévie. J’ai fait pas mal d’erreurs en chemin. La mise en œuvre concrète dépend des outils d’IA et de prise de notes que vous aimez ; vous n’êtes pas obligé de faire comme moi. Si vous avez des questions, vous pouvez me contacter. Si nous sommes assez nombreux, je créerai un groupe pour en discuter.